
«Традиційний пошук мертвий, а арбітражники та медіабайєри тепер мають забути про класичне SEO і перемкнутися виключно на генеративні платформи», — такі заголовки щодня ширяться соцмережами. Інформація в індустрії зазвичай рухається швидше, ніж її перевірка, і чимало нових тактик навмисно використовують як лякалки для продажу дорогих курсів чи сервісів.
Свіжий аналіз технічних даних і досліджень ринку показує, що значна частина поширених уявлень про AI-пошук не витримує зіткнення з реальністю. Розберемо головні міфи, які марно витрачають бюджети команд та спотворюють пріоритети в залівах.
Міф 1. AI повністю знищує класичний пошук і забирає весь трафік
Дехто вважає, що кожен запит у ChatGPT, Claude чи Perplexity — це готовий користувач, якого недоотримали традиційні пошукові системи на кшталт Google.
На практиці дані звітів про стан пошуку демонструють іншу картину: і традиційний, і генеративний пошук зростають майже паралельно. Поведінка користувачів еволюціонує за принципом «AI плюс класичний пошук», а не «або-або». Платформи штучного інтелекту не канібалізують усю пошукову базу, а додають новий шар зверху.
Частка правди у побоюваннях є: кліки на відкритий веб-павутинний простір падають, оскільки пошукачі все частіше прагнуть закрити інтернет-запит прямо на сторінці видачі без переходу на сайт. Для медіабайєрів це означає необхідність оптимізувати воронки під нульовий клік та фокусуватися на глибокій цінності контенту.
Міф 2. Штучний інтелект замінює ключові слова на промпти, а SEO-аудит більше не потрібен
Ідея про те, що класичне ядро запитів і технічна оптимізація відійшли в минуле, є фундаментальним непорозумінням того, як працюють великі мовні моделі. Штучний інтелект не створює інформацію з повітря — він спирається на живі пошукові запити, розгортає їх через механізми валідації та обирає джерела за алгоритмами, дуже схожими на пошукову видачу.
Технічні аудити, якість індексації та правильна структура посад досі визначають, чи побачить робот ваш сайт під час сканування. Глибший аналіз поведінки користувачів показує, що якісний контент, який задовольняє реальний намір (intent), дає стабільні результати як у Google, так і в AI-рекомендаціях.
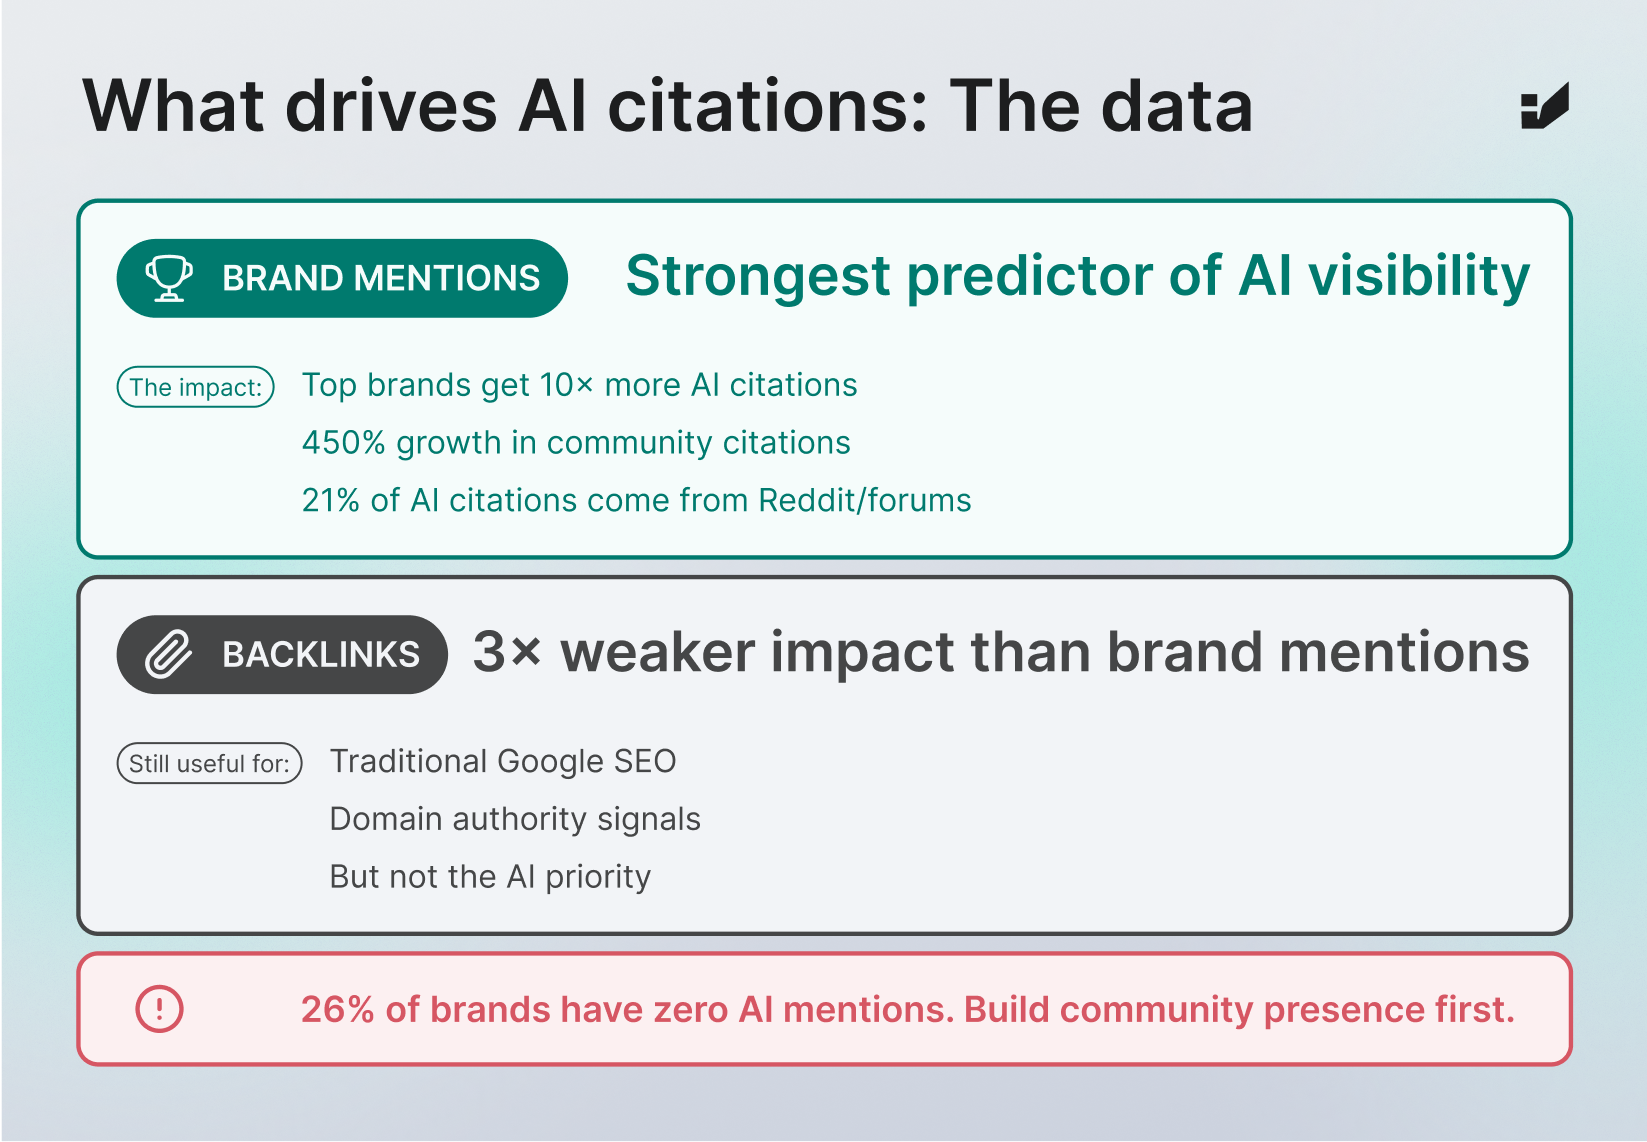
Міф 3. Публікація власних «best-of» списків гарантовано виведе бренд у топ рекомендацій AI
Багато компаній та афіліатів намагаються обійти алгоритми за допомогою створення списків на кшталт «10 найкращих інструментів для X», де на першому місці стоїть власний продукт. Експерименти з відстеженням тисяч відповідей у ChatGPT, Gemini та Perplexity доводять протилежне: хоча алгоритми можуть використати статтю як джерело інформації, вони далеко не завжди згадують бренд-автора у фінальній відповіді, а іноді й взагалі виводять у топ конкурентів.
«AI використовує ваш матеріал для синтезу, але сліпе самопромоутування не працює без зовнішніх сигналів авторитетності», — зазначають експерти галузі.
Довгострокова видимість в AI-відповідях будується через зовнішні згадки, незалежні огляди, роботу з інфлюенсерами та формування стійкої присутності на авторитетних сторонніх ресурсах, яким штучний інтелект довіряє більше, ніж брендовим сайтам.
Що це означає для арбітражу та індустрії
Зміна правил гри вимагає від команд прагматичного підходу без паніки та крайнощів:
- Фокус на нижню частину воронки: сторінки продуктів, глибокі порівняння та детальні огляди конвертують трафік значно краще за розмитий загальний контент.
- Якість замість генеративного спаму: масовий запуск штучних текстів без експертизи більше не дає переваги, оскільки алгоритми навчилися відсікати порожній шум.
- Оцінка метрик ефективності: відстежуйте не лише номінальні покази, а реальні ліди та якість конверсій, які приходять із нових джерел.
Гібридна реальність пошуку вимагає гнучкості: адаптуйте стратегії під реальні дані досліджень, а не під гучні заголовки про повну смерть класичного digital-маркетингу.
🖋 UAFF — будь в курсі арбітражних інсайтів